作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3400 字 | 预计阅读 10 分钟,后有完整回测代码,建议先收藏
想写这篇主要是因为市面上自动画线的工具教程都在讲怎么找线,没人讲找到之后,在什么票上能用。
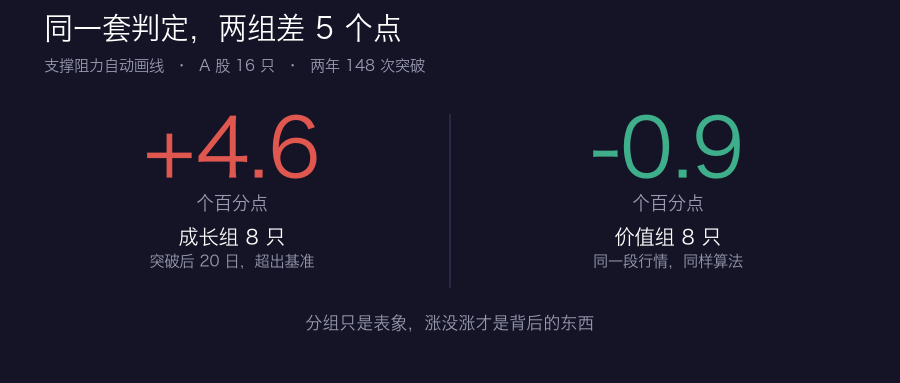
今天我就用 16 只 A 股,一套代码,两组结果差 5 个点的例子来给大家讲讲。
两组中成长组 8 只,向上突破后 20 天比同期基准多赚 4.61 个百分点。价值组 8 只倒亏 0.93 个点。
接下里的内容会拆成两半,先讲线怎么画、怎么判断破没破,再讲我跑出来的那个分水岭。
两组差在哪
先看结果。两个池子各 8 只,同一段区间,同一套参数。
| 组别 | 次数 | 5日 | 10日 | 20日 | 基准 | 收回 |
|---|---|---|---|---|---|---|
| 成长组 | 41 | +1.30 | +2.14 | +6.77 | +2.16 | 59 |
| 价值组 | 47 | +0.54 | +0.02 | -0.20 | +0.73 | 69 |
下面三行都是百分比,收益从突破当天收盘价起算,未扣成本。
成长组 20 天赚 6.77%,同期随便哪天是 2.16%。多出 4.61 个点。价值组 20 天是 -0.20%,基准 0.73%。倒亏 0.93 个点。
“收回”那一列说明同样的事。突破之后 10 天内收盘又跌回线内的比例,成长组 24/41 等于 59%,价值组 31/45 等于 69%。价值组不只是赚不到,假的还更多。
成长组是宁德时代、比亚迪、中芯国际、北方华创、寒武纪、工业富联、立讯精密、东方财富。价值组是贵州茅台、招商银行、中国平安、长江电力、中国神华、万华化学、紫金矿业、海螺水泥。
选股不是随机抽的。成长组按行业属性挑了五个方向里市值靠前的:新能源、半导体、AI 算力、消费电子、券商。价值组挑了白酒、银行、保险、电力、煤炭、化工、有色、建材各一只。两组都要求这两年没有长期停牌。
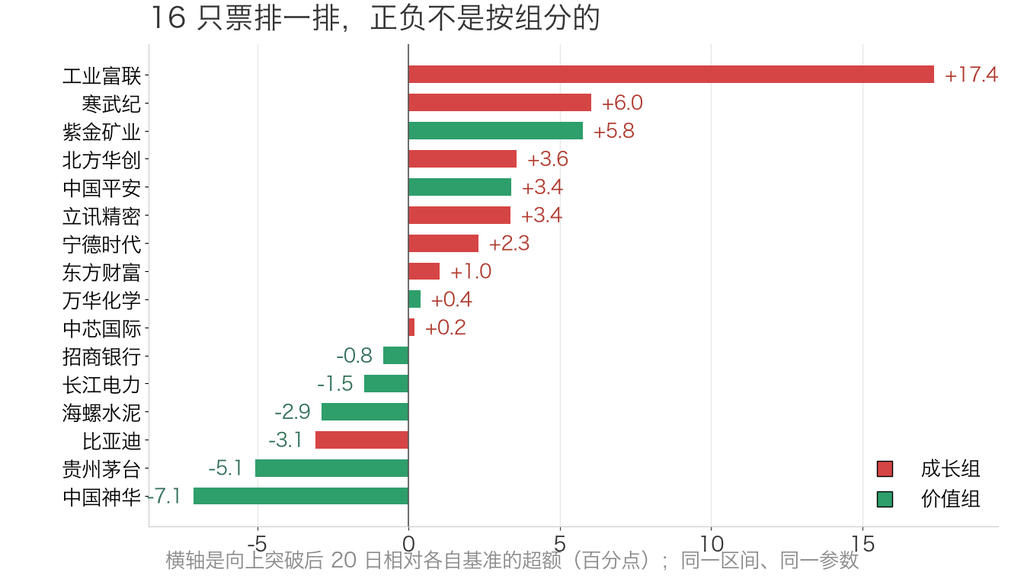
每只票一根柱,横轴是它自己突破超额的票内均值;红成长、绿价值
排开一看,正负不是按组分的。
成长组 8 只里 7 只为正,只有比亚迪 -3.1。价值组 8 只里 3 只为正,紫金矿业 +5.8 排到第三,比宁德时代的 +2.3 还高。
分界线看起来很清楚,但紫金矿业这根柱子插在中间,说明还有别的东西在起作用。
三条条件,和一个迟到的拐点
程序自己不判断哪条线重要,它先把候选位置找出来。做法很土,每天往回看,问一个固定问题,15 个交易日之前的那个高点,是不是前后 15 天里最高的。是,就记一条阻力线。低点同理,记一条支撑线。
for i in range(order, len(df)):
    t = i - order
    win = highs[t - order : t + order + 1]
    if len(win) == 2 * order + 1:
        if highs[t] == win.max():
            levels.append(highs[t])
order 就是那个 15。这段代码有个副作用值得先说清,第 31 根 K 线之前不会有任何线,因为凑不满一个 31 天窗口。
线有了,再判断破没破。三条同时成立才算。
第一条,收盘价要站在线的另一侧。盘中戳一下又回来不算,只看收盘。
第二条,前一个交易日的收盘还在原位。这条保证信号打在突破当天,不是几天之后补记。
第三条,当天成交量不低于 20 日均量的 1.2 倍。这条的意思是不想在无人区里认突破。
vol_sma = pd.Series(vol).rolling(20).mean()
heavy = vol[i] >= 1.2 * vol_sma[i]
for lv in levels.copy():
    up = close[i] > lv and close[i-1] <= lv
    if up and heavy:
        breaks.append((dates[i], lv))
        levels.remove(lv)
最后那行 remove 容易漏。不删的话同一条线会被反复算破,频率统计全废。
还有一个躲不开的代价,拐点必须迟到。走完的图上拐点一眼看见,但站在那一天没人知道,第二天还可能接着涨。用只有事后才认得出的拐点做测试,回测会好看得离谱,实盘复现不了,这个毛病叫未来函数。
上面的循环绕开了它。拐点永远在被确认之后 15 天才进候选池,第 45 天确认第 30 天的高点,用的全是当天已经能看到的数据。
代价是实打实的。成长组 68 次突破,从确认到真破,平均还要再等 66 个交易日,中位数 40 天。
等程序把这条线画出来,价格已经在它附近磨了一个多月,中位数 40 天。这个设计我认为是对的,拿 15 天换不撒谎。但要清楚它换掉的是什么,它把“抓突破”变成了“记录突破”。
宁德时代这半年,七条线两次被穿
拿宁德时代单独看,2025 年 4 月到 12 月,186 根日线。程序全程画出 7 条线,触发 2 次向上突破。
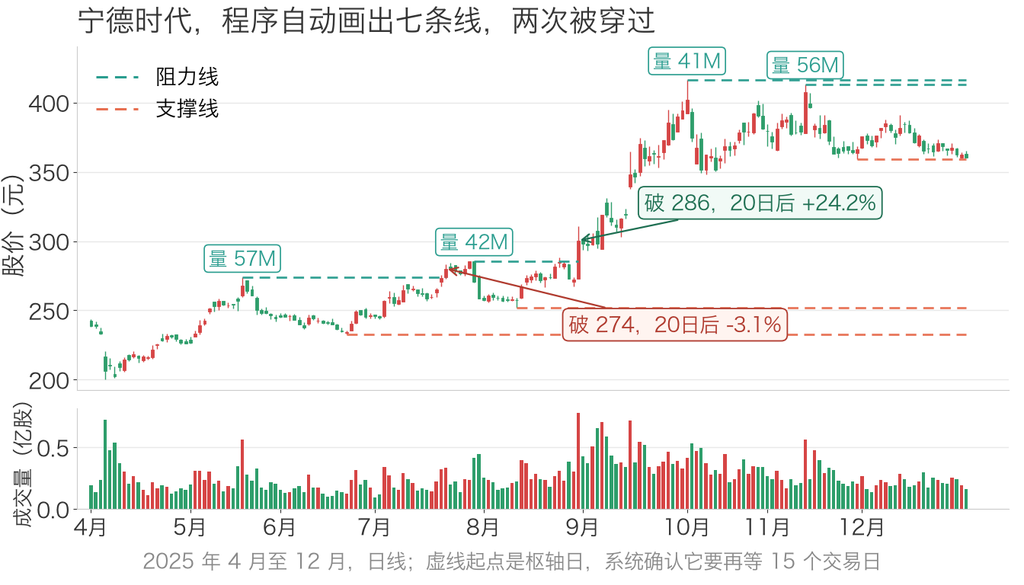
7 月 22 日破 273.68,20 个交易日后 -3.1%。8 月 29 日破 285.62,20 个交易日后 +24.2%。
同一只票,同一个判定,相隔一个月,一个假一个真。
差别在成交量上。7 月 22 日那次成交 3330 万股,量比 1.54。8 月 29 日那次 7801 万股,量比 2.78。我盯着这两根量柱看了半天,2.3 倍的差距,后面跟着 27 个点的差距。
七条线里活得最久的是 232.67 那条支撑。6 月 23 日画出来,到 12 月 31 日都没被跌破,横跨 131 根日线。
这就是为什么单看一两次突破说明不了任何事。半年 2 次,怎么排都排不出规律。
— · —
以上是线和判定怎么来的,往下是为什么两组差这么多。
涨得多的票,突破才管用
两组差 5 个点,我第一反应是“成长股的动量属性强”。这个解释很顺,顺到我当时差点就把它写进结论。
但我先把 16 只票的两年涨幅拉出来,和它们的超额放在一张图上。
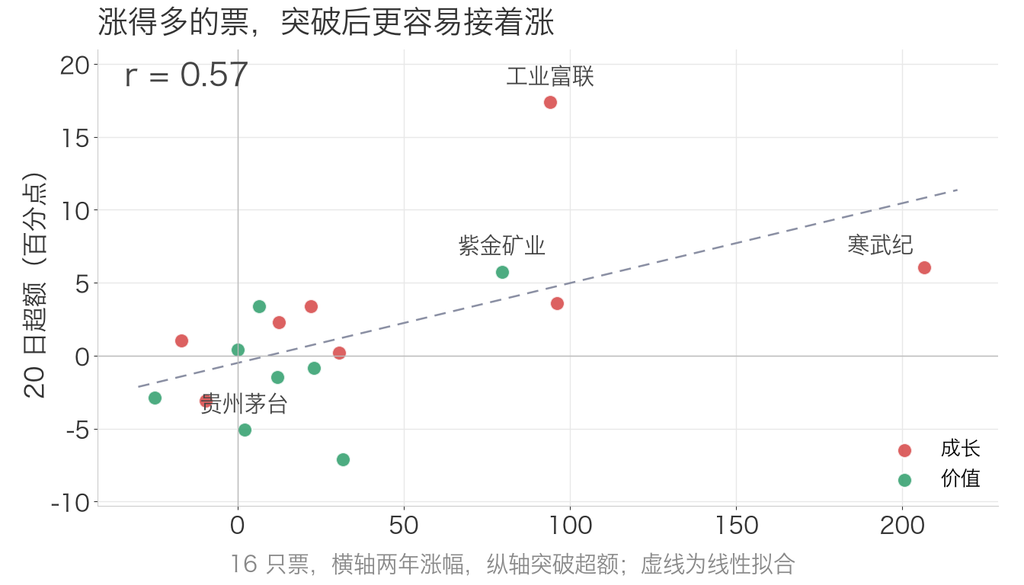
相关系数 0.57。把纵轴换成突破后 20 天的真实收益,相关系数升到 0.74。
换成更直白的切法。16 只票按两年涨幅取中位(17.3%),高的那一半超额均值 +3.54,低的那一半 -0.68,差了 4.22 个点。
而按成长、价值切,两组差 4.83 个点。这两个数字几乎一样大。
也就是说,我分不清这两组差的 5 个点,是“成长股”这三个字带来的,还是“这两年的行情恰好落在它们身上”。我说不好。在我这个样本里,这两个变量是同一个人。
说到底,分组只是表象,涨没涨才是背后的东西。而事前往往只能看到它属于哪个板块,看不到它接下来两年会不会涨。
补一个反例。价值组里紫金矿业 +5.8,两年涨 79%;成长组里比亚迪 -3.1,两年跌 9%。分组和涨跌并不完全重合,这也是为什么相关系数只有 0.57,不是 0.9。
窗宽一改,信号差八倍
order 是这套方法里唯一的旋钮,15 不是定理。我拿两组的日线,把 order 从 3 扫到 30,两年内的突破次数是这样。
| order | 成长组线条 | 成长组突破 | 价值组线条 | 价值组突破 |
|---|---|---|---|---|
| 3 | 759 | 265 | 758 | 302 |
| 8 | 304 | 129 | 301 | 147 |
| 15 | 144 | 68 | 159 | 80 |
| 30 | 74 | 32 | 74 | 35 |
order 从 30 放到 3,成长组的突破从 32 次涨到 265 次。八倍多。图上线密到看不清哪条是哪条。
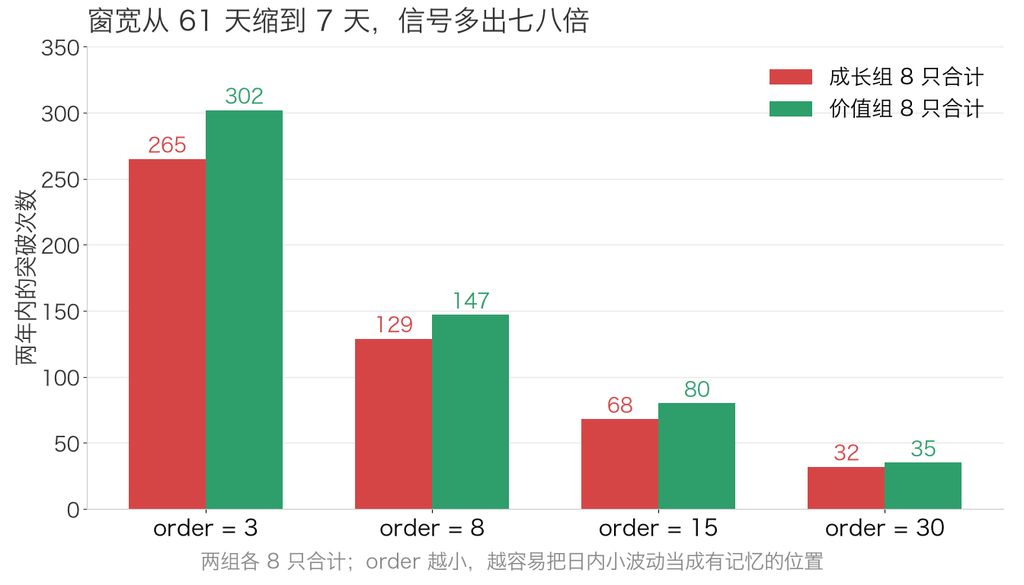
扫完这四档,15 这个默认值在我这儿变味了。它不像反复调出来的,更像随手定的一个整数。
这里没有最优值。order 小,线多信号密噪音也多。order 大,线少信号稀,每条更结实。我的取法是 15 到 20,这段区间线的数量和肉眼能记住的差不多。
量能门槛在两边表现不一样
第三条条件要求放量。我把门槛从“不设”提到 1.2 倍、1.5 倍,两组的结果走向不同。
| 门槛 | 成长突破 | 成长10日 | 成长收回 | 价值突破 | 价值10日 | 价值收回 |
|---|---|---|---|---|---|---|
| 不设 | 43 | +2.81 | 58% | 56 | -0.39 | 74% |
| 1.2 倍 | 41 | +2.14 | 59% | 47 | +0.02 | 69% |
| 1.5 倍 | 33 | +3.34 | 52% | 37 | +0.05 | 65% |
成长组门槛提到 1.5 倍,假突破从 58% 降到 52%,收益反而升到 3.34%。价值组同样提到 1.5 倍,收益从 -0.39 爬到 0.05。还是没爬过零轴。
同一个门槛,在成长组是“筛掉噪音”,在价值组只是“筛掉信号”。差别不在门槛,在池子。
同一天被画了三条线
有一件事我改了两遍,得交代。
成长组第一版统计跑出 82 条突破,价值组 102 条。数字是我核对的,但没先查同一天有没有重复。
查了才发现,成长组 14 条、价值组 22 条是同一天同一方向被数了好几遍。原因是程序不合并同价位的线。相邻几天的枢轴点各自都能通过判定,同一根大阳线扫过去,几条线一起失效。
去重之后是 68 条和 80 条。看上去只是数字变小,但分组结论跟着动了。
真正该做的处理只有一行,按日期去重,一天一个方向只算一次。上面的表格和结论,都是去重之后的
它更适合当画图工具
跑完这一圈,我对它的定位变了。
当自动画图用。以前手动拖水平线,一周一次,拖完就忘。现在一条循环跑完,位置、起点、破没破都整整齐齐。当复盘用,哪条线一年里被摸过三次以上、破了以后又回去,一眼就看得到。
当位置提醒,我更倾向把它当减速带,不当刹车片。线就在头顶时,手会慢一点,破不破、破完涨不涨,交给别的判断。
不做的只有一件,把它标出来的突破当信号去执行。前面那个 5 个点的差距已经说明了,同一套判定换个池子就是另一个结论。你没有理由相信它在你手上,会站在好的一边。
观点总结
支撑阻力是过去某一天多空打了一架留下的记录,自动画线把这份记录整理得挺准。
但记录是记录。同一个价位被守过三次,第四次守不守得住,跟前面三次没关系。
所以我的结论就一句:这个方法真正的变量不是参数,是你把它套在哪 8 只票上。而选票这件事,本来就不是它能替你做的。我更倾向把它放在“复盘”这一格,而不是“信号源”那一格。
我手里的样本是 16 只、两年、148 次去重后的突破,不算大。说不好换个时段会是什么样,大家的经验如果和这个反着,那就以大家的为准。
顺便问一句,大家选票的时候,会先看这只票过去一年是往上走还是往下走吗?
觉得有用的话,把这篇转给同样在搞量化的朋友。
完整脚本,复制就能跑
前面拆开的每一步,合起来就是下面这段。装好 akshare,把 START 和 END 改成自己想要的区间,直接跑。
输出会先打每只票的原始突破数和去重后的数,最后给两组汇总。我这边跑出来是成长组 41 次向上、20 日 +6.77%,价值组 47 次、-0.20%,和上面的表对得上。
import akshare as ak
import pandas as pd
import numpy as np

ORDER, VMUL = 15, 1.2
START, END = "20241101", "20261105"

# 成长组:宁德时代 比亚迪 中芯国际 北方华创
#         寒武纪 工业富联 立讯精密 东方财富
GROW = ["sz300750", "sz002594", "sh688981",
        "sz002371", "sh688256", "sh601138",
        "sz002475", "sz300059"]

# 价值组:贵州茅台 招商银行 中国平安 长江电力
#         中国神华 万华化学 紫金矿业 海螺水泥
VALUE = ["sh600519", "sh600036", "sh601318",
         "sh600900", "sh601088", "sh600309",
         "sh601899", "sh600585"]


def load(code):
    d = ak.stock_zh_a_daily(
        symbol=code, start_date=START,
        end_date=END, adjust="qfq")
    d["date"] = pd.to_datetime(d["date"])
    cols = ["date", "high", "low",
            "close", "volume"]
    return d[cols].dropna().reset_index()


def scan(d, order=ORDER, vmul=VMUL):
    """逐日推进,三条同时成立才算破"""
    h, l = d.high.values, d.low.values
    c, v = d.close.values, d.volume.values
    vs = pd.Series(v).rolling(20).mean()
    live, hits = [], []
    for i in range(order, len(d)):
        t = i - order
        lo, hi = t - order, t + order
        if lo >= 0 and hi < len(d):
            if h[t] == h[lo:hi + 1].max():
                live.append([t, h[t], "res"])
            if l[t] == l[lo:hi + 1].min():
                live.append([t, l[t], "sup"])
        heavy = (not np.isnan(vs[i]))
        heavy = heavy and v[i] >= vmul * vs[i]
        for it in live[:]:
            lv = it[1]
            if it[2] == "res":
                hit = c[i] > lv >= c[i - 1]
            else:
                hit = c[i] < lv <= c[i - 1]
            if heavy and hit:
                row = {"i": i, "k": it[2]}
                row["lv"] = lv
                hits.append(row)
                live.remove(it)
    return hits


def dedup(hits):
    """同一天同一方向只算一次,留价位最高的"""
    seen, keep = set(), []
    hits.sort(key=lambda z: -z["lv"])
    for x in hits:
        key = (x["i"], x["k"])
        if key in seen:
            continue
        seen.add(key)
        keep.append(x)
    return sorted(keep, key=lambda z: z["i"])


def stats(d, hits):
    c = d.close.values
    n = len(c)
    up, down = [], []
    for x in hits:
        i, lv = x["i"], x["lv"]
        j = i + 20
        f = None
        if j < n:
            f = (c[j]/c[i]-1) * 100
        fake = None
        if i + 10 < n:
            seg = c[i + 1:i + 11]
            if x["k"] == "res":
                fake = bool((seg < lv).any())
            else:
                fake = bool((seg > lv).any())
        row = {"fwd20": f, "fake": fake}
        if x["k"] == "res":
            up.append(row)
        else:
            down.append(row)
    m = n - 20
    base = [c[i+20]/c[i]-1 for i in range(m)]
    return up, down, np.mean(base) * 100


def run(pool, label):
    allup, allbase = [], []
    for code in pool:
        d = load(code)
        raw = scan(d)
        hits = dedup(raw)
        up, _, base = stats(d, hits)
        allup += up
        allbase.append(base)
        print(code, len(raw), "->", len(hits))
    f = [x["fwd20"] for x in allup]
    f = [v for v in f if v is not None]
    fake = [x["fake"] for x in allup]
    fake = [v for v in fake if v is not None]
    print(f"\n[{label}] 向上突破 {len(allup)} 次")
    print(f"  20 日均值 {np.mean(f):+.2f}%")
    print(f"  同期基准 {np.mean(allbase):+.2f}%")
    print("  收回", sum(fake), "/", len(fake))


if __name__ == "__main__":
    run(GROW, "成长组")
run(VALUE, "价值组")两个地方容易改错。scan 里的 live 列表只存还没被破的线,破了就 remove,不删同一条线会被反复计数。dedup 必须按「日期 + 方向」去重,只按价位去重会漏掉同一天不同价位的重复。
想换成自己的票,改 GROW 和 VALUE 两个列表就行。代码用新浪接口的前缀格式,sh 或 sz 加六位数字。
Be First to Comment