作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。
模型评测不等于投资建议。
不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3400 字 | 预计阅读 8 分钟,后半是三处代码实现的核对,建议先收藏
KHunter 这个项目,我是从一个开源量化群里看到的。群友开口第一句是:终于有人把 A 股选股、买卖择时和策略回测做成一套了,后面还跟着六条能力介绍。
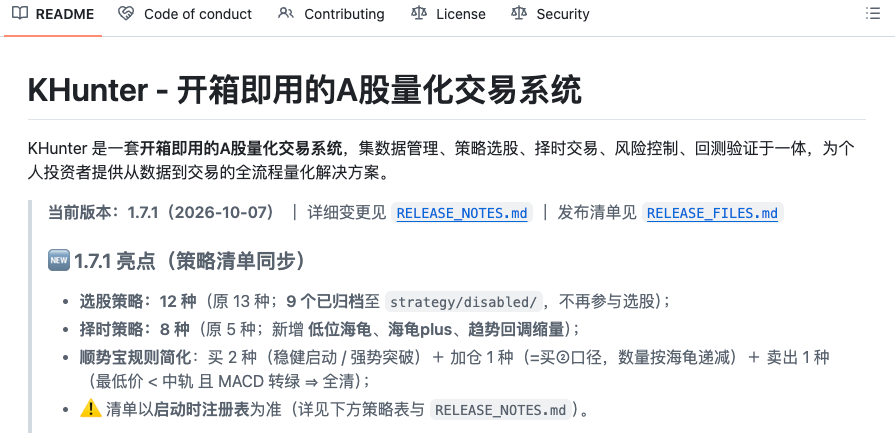
说实话这类文案我今年看过不少,列的能力各不一样,落点都是同一句,开箱即用。
我对这四个字有本能怀疑,这也是我想写这篇的原因。做过回测的都清楚,一套系统最难的部分从来不是策略,是数据对不对得齐、成交假设合不合理、配置跟代码是不是同一份。这三件里错一件,跑出来的曲线还剩什么?
所以这篇不评它好不好用。先看它怎么搭起来,往下拆三处关键实现,一处成本口径、一处时点口径、一处进场过滤。
我把 clone 下来的代码按目录一层层读了一遍,顺手在本地跑起来了。跑得动,但没跑完,哪一步停的下面一并写清楚。
先把它是什么说清楚
它是一个 Python 写的 A 股研究系统,676 个 star、180 个 fork,仓库今年三月建,最后一次提交在十月七号,版本号 1.7.1。
体量 95,388 行 Python。这个数字得拆开看,因为分布极不均匀。
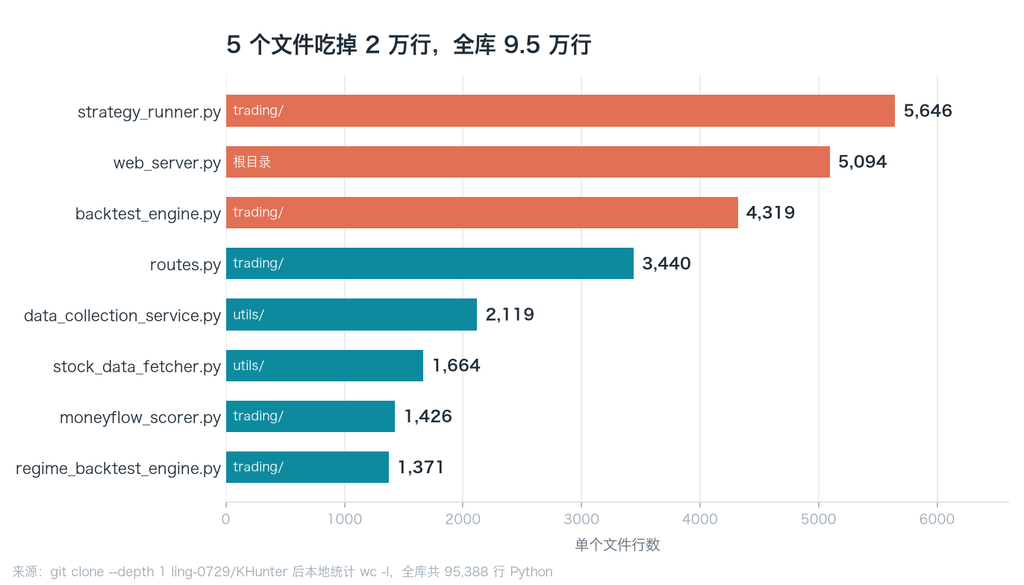
五个文件吃掉 20,618 行,占全库两成。策略运行器 5,646 行、web_server 5,094 行、回测引擎 4,319 行、路由 3,440 行、数据采集 2,119 行。两个五千行级的单文件分别躺在根目录和 trading 下面,你要改一个函数,先得在几万行里把它找出来。
我得先承认一件事。我一开始判断这是 AI 拼出来的。证据挺足,README 里到处是 ✓ 和 ✗ 两种符号,注释格式统一到不像手写。
这个判断在读到回测引擎第 1032 行时塌了。那里有一行注释,抄的是用户原话,说上一轮那个大盘 ADX 首仓闸门取消,改由仓位上限总控。会把自己的需求记录一行行写进代码的人,通常是在真跑这套东西。
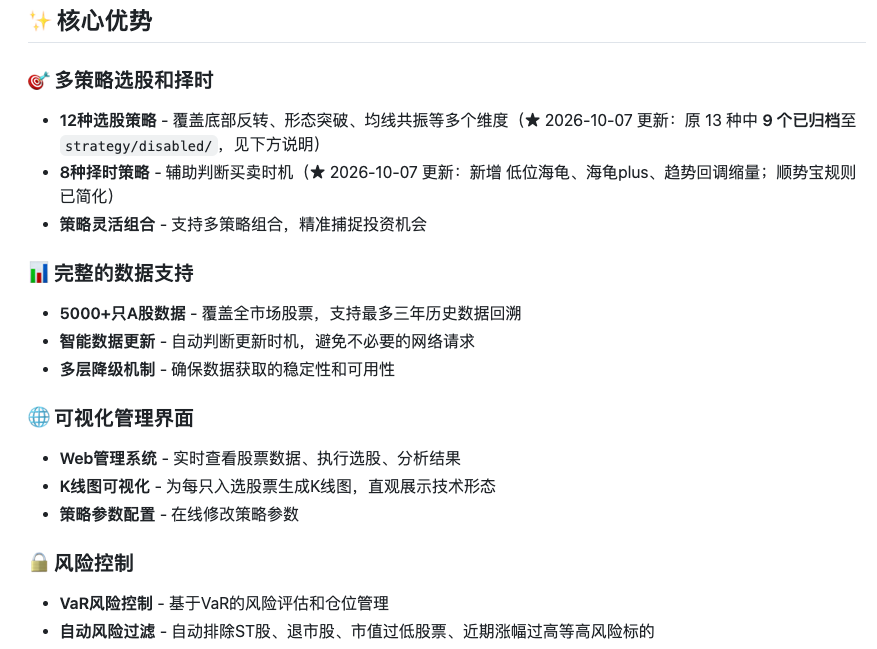
它对外讲四项能力,12 套选股、8 套择时、五维评分、全市场数据。这四项我都验了,但验出来的结论不一样,后面分开讲。
我先把它跑起来了
装它比预想的顺利。依赖 16 个包,全是 pip 能直装的常规库,没有私有源、没有编译依赖、没有必须联网下载的模型权重。
门槛在数据。它接两个源,akshare 免费,tushare 要 token。我先走免费那条。
拉全市场股票列表,5,402 只,88.7 秒。
拉一只股票的三年日线,600519,1,500 根,4.5 秒,前复权。
Web 界面用 flask 测试客户端请求首页,返回 200,正文 19.9 万字节。启动日志里 12 个策略逐个注册,名字和文档那张表逐字对得上。
到这一步,它能跑。但能跑的范围是「装上、起来、拉到数据」,不含「选股能选出东西」。
要选股,得先把五千只股票的历史 K 线灌进本地 SQLite。按单只 4.5 秒推算,串行跑完六个多小时。这是净拉数的时间,没算写库和失败重试。
六个小时的等待对一次试玩来说太长,我没启动。单只 4.5 秒这个数看一遍,量级就出来了,不用真等。我说不好这六个小时花下去值不值,至少对我来说不值。我停在数据这一层,把力气挪到读代码上。
怎么装(五步)
第一步克隆。git clone 下来,目录结构很规整,strategy 放选股,trading 放回测与择时,utils 放数据与工具。
第二步装依赖。pip install -r requirements.txt。这一条的坑写在文档里,Python 版本必须 3.10 以上。代码里用了 StrategyRunner | None 这种联合类型注解,文件头又没加 from __future__ import annotations,3.8 和 3.9 会直接报错起不来。
第三步起界面。python main.py web,默认 5001 端口。Windows 下可以直接双击根目录的 start.bat。
第四步初始化数据。这一步在 Web 界面里点,也可以跑 main.py 里的对应命令。全量第一次会很久,可以先只更一个板块试。
第五步跑一次选股,再跑一次评分,看结果能不能落库。选股和评分是两条独立链路,任一环数据缺失,结果就是空。
装上之后怎么用
它的正常路径是串起来的。选定股策略跑一遍,得到候选池;对候选池做五维评分排名;按分数和支撑价筛一遍进狩猎场;最后挂一个择时策略决定什么时候下手。
默认配置里选股用的是仙人指路,择时用的是支撑那套,评分阈值 60。这三个值都在 config/config.yaml 里,改起来方便。
有一点要注意,选股和择时是两套独立注册的模块,不是一一对应。12 套选股可以随便配 8 套择时里的任何一个,组合数 96 种。96 种组合,真有人全跑过一遍吗?我估计没有,反正我没有。组合多了不一定是好事,我在最后一节说为什么。
以上是普通读者的部分,装上就能用。往下是我读代码读出来的东西。
四条过滤,三条在跑
它进场前有一道 K 线过滤,代码在 trading/buy_filter.py。文件头列了四条规则。
规则一,前 20 个交易日的最低点到今日开盘,涨幅超过 50% 不买。
规则二,当日开盘涨跌幅超出 ±4% 不买。
规则三,BIAS5 大于 7 不买。这个指标量的是收盘价偏离五日均线多远,数字越大说明短期涨得越急。
规则四,近 30 个交易日没有涨停记录不买。
四条读下来都在防追高,逻辑成立。我顺手看了一眼主流程函数 check_filters,把它的 details 打出来。
只返回三个键,rise_from_low、open_rise、limit_up_history。规则三不见了。
我第一反应是自己参数传错了,又跑一遍,还是三个。然后把 buy_filter.py 拖到底,全文搜 _check_bias5 这四个字,我盯着结果看了半天。两次。一次是函数定义,一次是测试用例,主流程里一次都没有。
文件里 _check_bias5 这个函数完整存在,阈值 7.0 写死在配置里,连文档字符串都写全了,还有一条配套的测试用例。但 check_filters 从头到尾没调用它。
我不太信,造了一组数据去撞。60 根日线,第 40 根涨停,落在 30 日窗口内;今日开盘 10.30,相对昨收 10.00 涨 3%;前 20 日最低 9.90,到今日开盘涨 4.04%。三条都过。
第一次造数我漏了一步,收盘价没抬高,BIAS5 只有 5.91%,白白跑了一遍。把今日收盘改到 11.00,MA5 是 10.20,BIAS5 才到 7.84%,越过 7 的线。
主流程判定通过。单独调 _check_bias5,判定不通过。
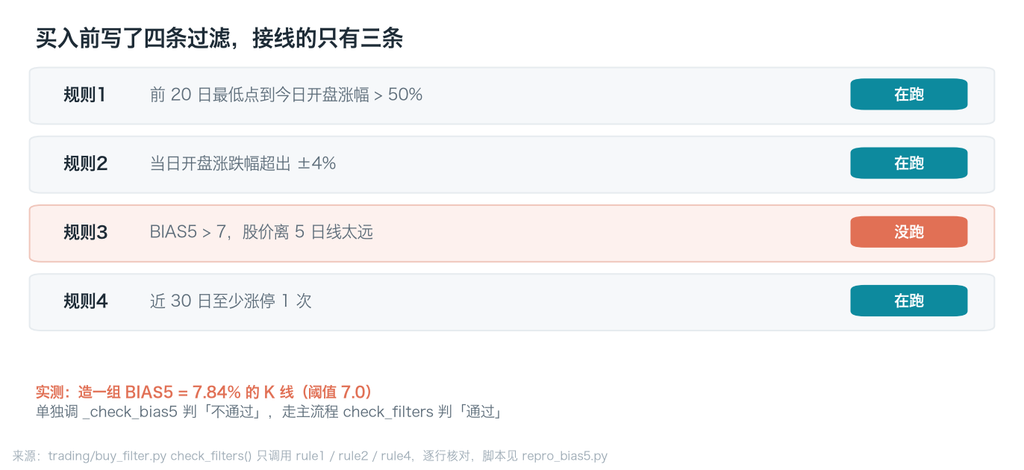
同一组 K 线,同一个文件,两个入口给出相反结论。原因只有一个:第三条规则从来没接上线。
这个洞的后果得说清。BIAS5 拦的是「今天已经涨飞了」的票,少了这一条,进场过滤只剩「别追太高」和「别追太急」,中间那层「别追已经涨了很久的」没了。
而 8 套择时里,海龟系那三套和顺势宝,全是往上突破才给进场信号的。布林带和 RSI 反过来,要等跌到超卖才动手。这四种里三种在追强势,进场过滤又少了防「涨久了」的那一道,最容易在情绪最热的那一格成交。
文件末尾那段注释里,还有一句更实在的。写测试的人自己标注了「BIAS5 规则在此未被覆盖到」,他已经发现用例没测到它,但没往下追一步。差一步,一个死函数就在仓库里躺了不知道多少个版本。
配置里 26 个,能跑 12 个
我一开始以为配置里那 26 个名字都能跑。翻到启动日志才发现不是,那两行隔了十几行,我一开始没连着看。
「配置文件加载成功,共 26 个策略」
「已加载 12 个策略」
相差 14 个。
再往下翻,支撑价那套配置加载了 20 个策略,又比 12 多 8 个。
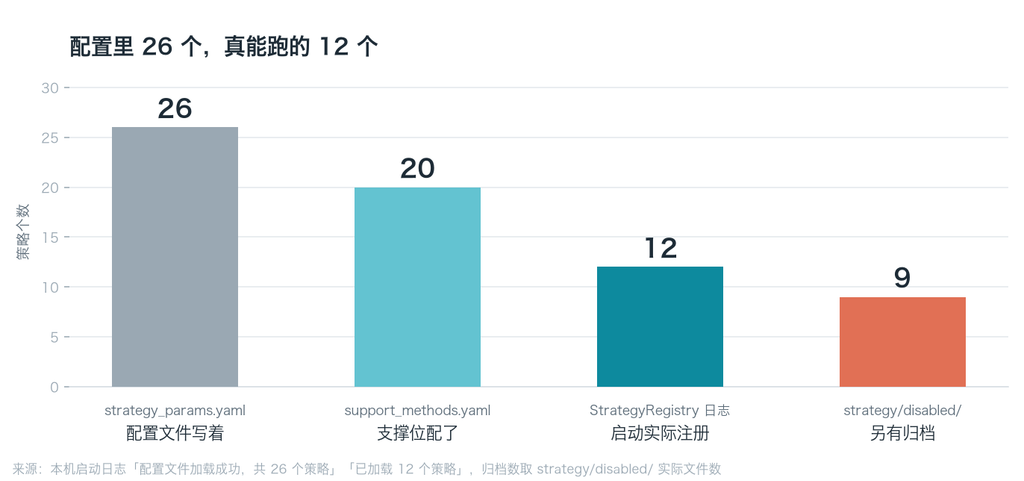
仓库文档自己承认了一半。config/strategy_order.yaml 里还列着 MTopStrategy、MultiDeathCrossStrategy 这些已经不存在的策略,注释里标了「历史遗留」四个字。
另外 9 个移进了 strategy/disabled/,不再参与选股。我数了一遍,目录里 8 个文件,加上根目录那个 _bowl_rebound_disabled.py,正好 9 个。
所以真实状态是三套数字并存。文档写 12 个,配置写 26 个,实际注册 12 个,另有 9 个留档。新人打开项目看到的第一眼是 26。
这种腐烂不致命,它不影响跑。但它决定了一件事,你没法靠配置文件名去推断系统行为,只能靠启动日志。一个系统的可信度,很多时候就取决于「读文档」和「看日志」这两个动作的结果差多少。
值得抄的三条口径
第一条,成本口径。
它把成本拆成四项。佣金万分之一点五,最低五元;印花税千分之一,只在出手那一端收;过户费十万分之一,只收沪市;滑点买卖各千分之三。
一买一卖合计 0.732%,其中滑点占了 0.6 个点,八成以上。
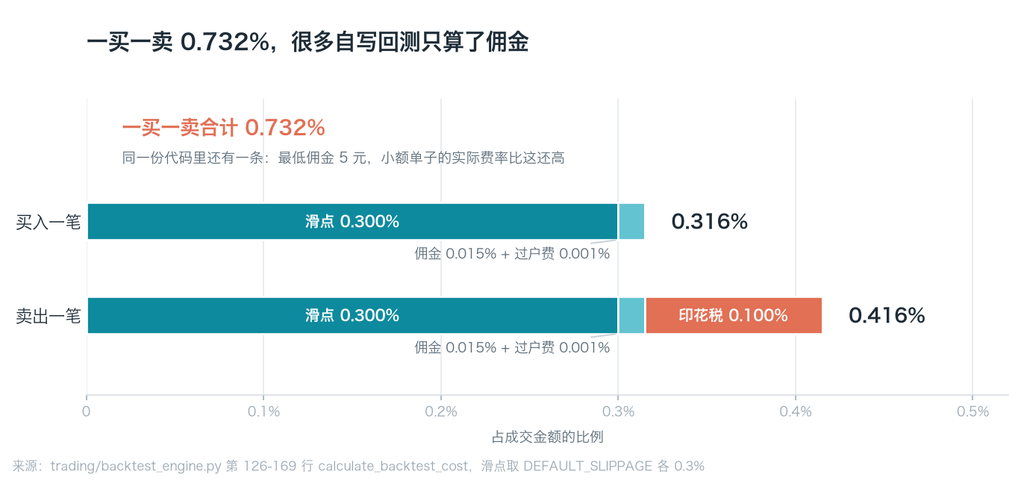
很多自写回测只算佣金,算完发现一年换手二十次也才千分之三,就把这一栏划掉了。划掉之前,有没有算过换手率乘上真实冲击成本是多少?A 股小票的冲击成本比佣金高一个数量级,把滑点补上,很多「微弱正收益」的策略会直接变成负的。
第二条,时点口径。
它的择时策略有一个参数叫 use_prev_day_signal,默认开。开了以后,信号取 df.iloc[-2],也就是前一根 K 线,成交价取 T 日开盘价。
八个择时策略里七个在文件里写了这个参数,我逐个核过。剩下那个低位海龟只覆盖了一个开关,把 MA20 过滤关掉,其余方法调父类,参数照样生效。
这一行代码的价值在于它把「收盘出信号、次日开盘成交」写进了接口层,不靠每个策略作者自己记得。我见过太多自研回测,信号和成交取同一根 K 线的收盘价,曲线漂亮得不像话,一上实盘就还债。
第三条,进场前的 K 线过滤本身。
不管第三条规则有没有接线,这套过滤的思路值得搬。前 20 日涨幅、开盘涨跌幅、近期涨停记录,三条都在回答同一个问题,这个位置进去,是不是在给别人抬轿。
这三样东西加起来不到一百行。我更倾向先抄这三条,而不是先跑那 12 套策略。
项目介绍里的三句话别太当真
第一句,开箱即用。
免费源能跑选股,这个是真的。但五维评分里资金流、基本面、板块、事件四维全挂在 tushare 上,只有技术面读本地库。仓库文档自己写着完整功能需要 6000 积分,Tushare 官方价目表上 5000 积分以上是 500 元一年。
换句话说,五维评分这个词在免费状态下只剩一维。
第二句,12 套策略。
12 个是真注册了,但 9 个被归档,配置里还躺着 26 个名字。策略本身也没名字那么玄。
我拆了一个最唬人的。「2560 战法」,实际是股价上穿 25 日均线、5 日均量上穿 60 日均量,两个均线条件。名字里的 25 和 60 就是这两个周期,跟战法没关系。
第三句,回测能验证策略。
仓库没有测试文件。文档自己写着 test_*.py 不入库,整个目录翻下来只有 trading/ptrade/test_strategy.py 一个,那是给券商接口做的样例。
9.5 万行代码,零测试。我觉得这不是道德问题,是能力问题。更要命的是它把这件事写在文档里,后面还带个对勾,好像这是个优点。没有测试,你改一个参数引发的连锁反应,只能等回测数字变了才发现,而回测数字本来就会变。
顺带提一句,我实跑时还撞到一个报错,代码引用了 utils/fix_stale_stock_names 这个模块,仓库里没有这个文件。模块级 except 把它吞掉了,只在日志里留一行。这类「本地有、公开版没有」的痕迹,说明公开仓库不是完整的开发树。
观点总结
回到开头那个问题。
开箱即用这句话,它解决了三分之一。装上能跑、数据能拉、界面能用,这一部分是真的,我实测过。策略能选出东西、评分能算准、回测能当依据,这一部分没解决,至少我没验证到。
我现在的判断是,这类项目当教材读比当工具用值钱。所以我从它身上拿走的不是 12 套策略,是三条口径。成本怎么拆、时点怎么钉、进场前该有几道闸。这三条跟具体策略无关,换任何一套自己的系统都用得上。
最后给一个动作。翻出你自己那套回测,找到下单那一段,看有没有「前 20 日最低点涨幅」这道闸。没有的话,把它加进去,再跑一遍你去年的结果。
数字会变。变多少,取决于你那套策略有多爱追强势股。
项目地址:https://github.com/ling-0729/KHunter
#量化交易 #A股 #开源项目 #回测 #选股策略 #择时 #交易成本 #Python #GitHub #代码审计 #风控 #BIAS5
Be First to Comment