作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。
模型评测不等于投资建议。
不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3200 字 | 预计阅读 10 分钟,后有完整代码和数据来源,建议先收藏
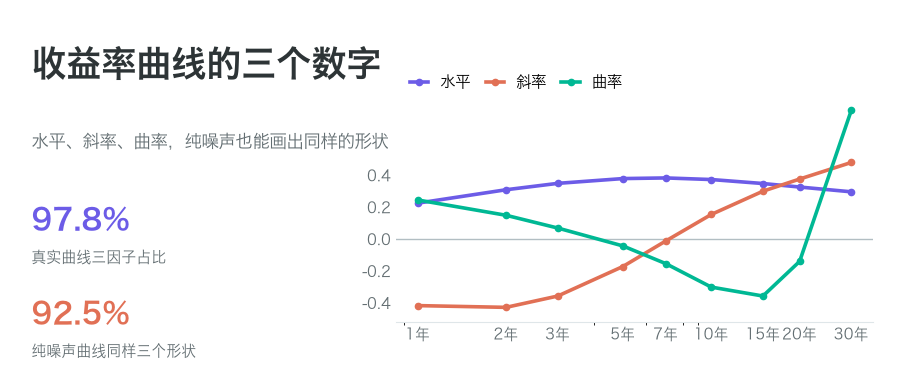
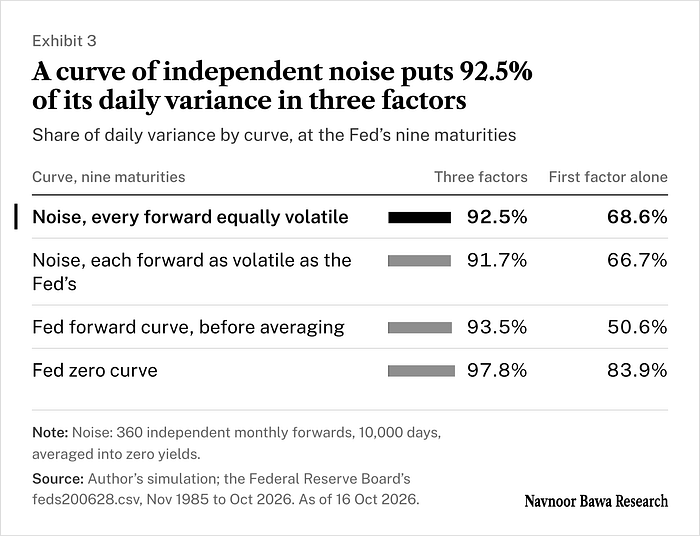
我用纯随机数造了一条收益率曲线:360个月度远期利率,每个月各自跳动,谁也不影响谁,市场信息被彻底拿掉。对它做同样的主成分分解,前三个因子解释了92.5%。形状也一模一样:一个全期限同号,一个穿零一次,一个穿零两次。
那在真实市场呢?
1985年11月到2026年10月,美联储零息收益率曲线10,208个交易日,每日变动拆成主成分,前三个因子解释97.8%。改用一年期滚动窗口,9,957个窗口里最差也有95.7%。旧金山联储2003年的一封信说得更满:三个因子能抓住各种国债收益率超过99%的变动。
水平、斜率、曲率。高盛1991年那篇论文给这三个数字起了名字,三十五年后全世界利率交易台还在用。
我照着公开数据,把四十年和那个噪声实验都重跑了一遍。一开始看到97.8%,我真以为市场里存在某种极深的结构;后来才明白,一多半是算术白送的。
这篇文章接下来讲我跑出了什么,以及这三个数字在哪里会骗人。
一、3个数字是哪三个
1986年,高盛把Robert Litterman从明尼阿波利斯美联储请到华尔街。他一去就管风险,后来回忆说,那时候我们既没有网络也没有算力,把公司的仓位加起来都办不到。跟他同在Financial Strategies Group的,还有芝加哥大学经济学家José Scheinkman。
问题很直接。一整个债券组合的风险,最少能用几个数字代表。
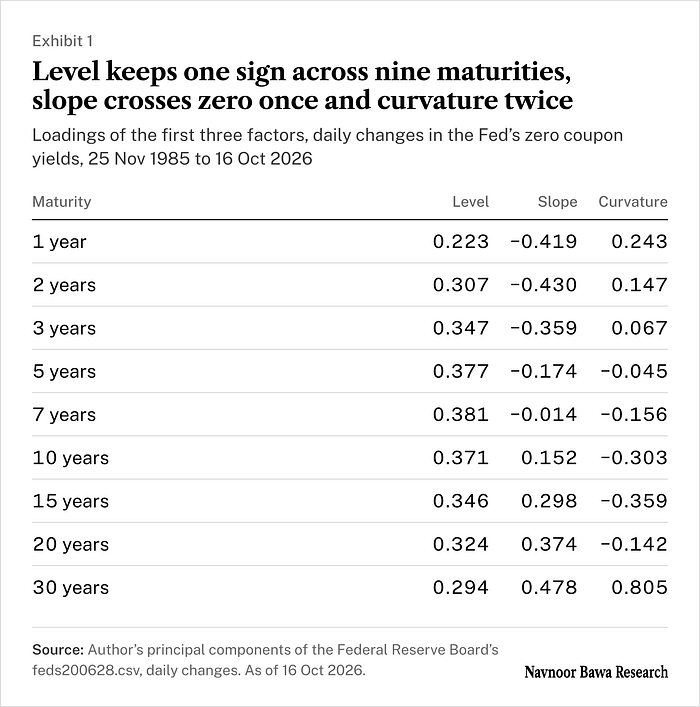
他们1991年交出答案,论文叫《Common Factors Affecting Bond Returns》。国债收益率的变动能分解成三个因子。第一个叫水平,所有期限同向动。第二个叫斜率,短端和长端反向动。第三个叫曲率,中间和两头反向动。
我把美联储的数据按九个期限重算了一遍,1年、2年、3年、5年、7年、10年、15年、20年、30年。每个期限在三个因子里的权重,一格一格对得上。水平因子全为正,1年0.223,7年最高0.381。斜率因子短端-0.419,穿零到30年的+0.478。曲率因子最歪,1年+0.243,5年-0.045,30年+0.805。
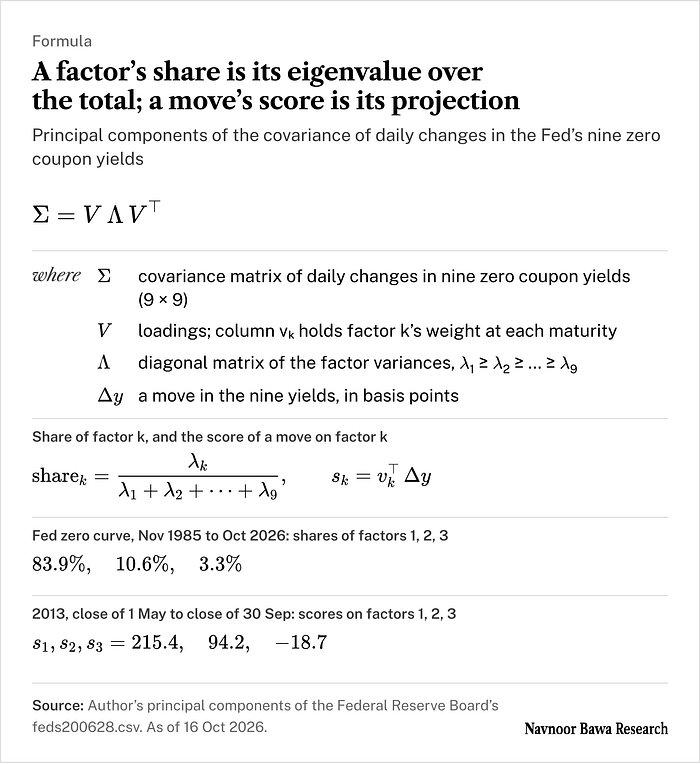
占比掉得飞快,83.9%、10.6%、3.3%。原因不复杂。相邻期限几乎一起动,第一个模式吃掉的正是它们共享的部分,轮到第二个只剩个倾斜,第三个只剩个弯曲。
二、3个数字怎么用
先补个背景。久期衡量债券价格对收益率平行移动的敏感度。交易台做多10年、做空2年,两边久期配平,理论上平行移动不赚不亏,赌的是10年和2年的利差。这就是最简单的曲线交易,行话叫2s10s。久期中性听着天经地义,我当时也这么想。
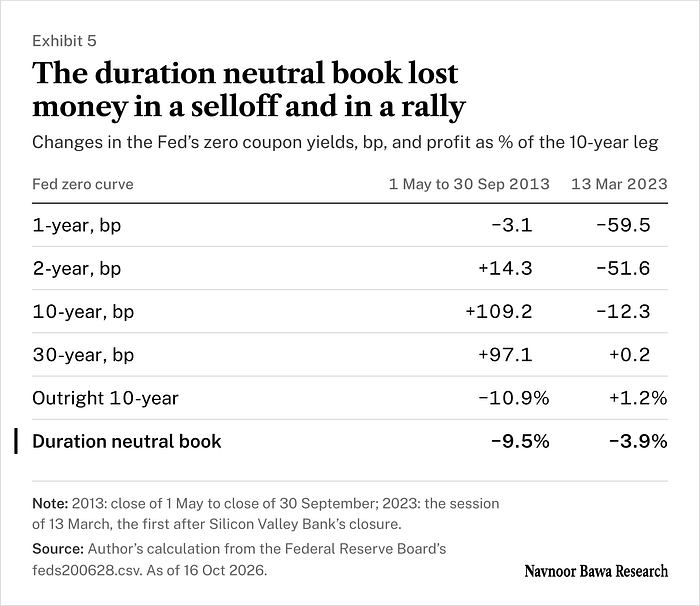
2013年夏天是现成的教材。5月1日到9月30日,1年零息利率跌3.1个基点,10年涨109.2个基点。前端几乎没动,长端独自上行。久期看不见这种移动,它假设所有期限一起动。
按三个数字给这轮移动打分,水平贡献80个基点,斜率14个,合起来把10年的109.2还原出98.3%。1年那边,水平的+48被斜率的-39抵掉,所以前端看着没动。
这个久期中性的组合,整个夏天亏了本金的9.5%,同期裸持10年零息亏10.9%。对冲留下了87%的亏损。不是对冲错了,是对冲只认平行移动,而曲线是歪着动的。
三、98% 稳得有点可疑
这三个数字的比例,稳到不正常。
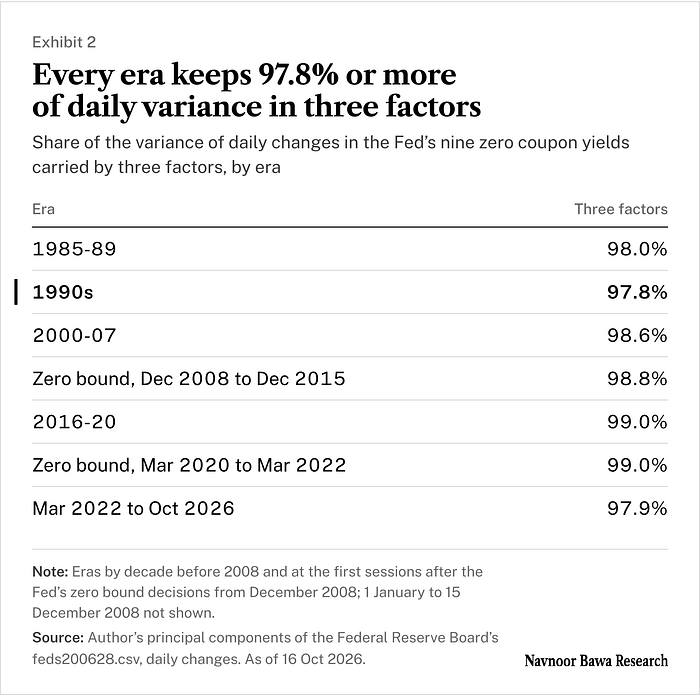
七个时代,从1980年代末,到两段零利率时期,再到2022年3月以后,三因子占比全在97.8%以上,1990年代垫底。时代这么不同,比例几乎不动。
统计上说,这个占比对分布变化完全不敏感,只有两种可能。它测的是市场里某种极深的结构,或者它测的是尺子自己。是哪一个?
三种解释摆在这。我一开始最信平滑器那个,数据科学家的第一反应。经济力量说,市场里真有三股力,主成分把它们捞了出来,那噪声曲线应该既画不出三个形状,也拿不到接近的占比。取平均说,零息利率是月度远期的平均,10年是120个月的均值,7年和10年共享前84个月,天然绑在一起,那独立远期平均出来的曲线应该照样画出三个形状。平滑器说,美联储公布的曲线本来就是个公式画出来的,Svensson模型,六个参数,对这么一条光滑的线做主成分,当然只剩几个因子,那换个方法拟合的曲线应该明显更低。
我逐个验了一遍。
四、纯噪声曲线
要分开这三种解释,得造一条没有市场的曲线。
360个月度远期利率,每天各自独立随机跳动,波动率统一按5%算。每个零息利率是对应期限之前所有月度远期的平均。在这条曲线上做同样的分解。
92.5%。第一因子68.6%,特征向量的形状和真实曲线一致。我盯着0.925看了好几遍,换五个随机种子,92.5%到92.6%。换成相关矩阵来算,噪声87.1%,真实曲线97.6%。
0.925这个数出来的时候我停了一下。三个数字的形状,大部分是取平均这件小事自己长出来的,跟经济力量没什么关系。
平滑那个解释也被排掉了。美国财政部自己公布日度到期收益率曲线,拟合方法和美联储不同。同样八千多个交易日、七个期限,财政部曲线三因子占比97.9%,美联储曲线98.7%,同样期限的噪声曲线94.2%。平滑的功劳不到一个点。
市场真正加进去的东西在两头。1年和10年零息利率的日变化相关系数,真实曲线0.66,噪声曲线0.26。平均能把相邻期限绑在一起,对隔了九年的两头就无能为力了,是市场把它们绑在一起的。我更倾向把这部分,看成98%里真正属于经济的。零利率时期还把这个连接砍了,2008年12月到2015年12月降到0.51,2020年3月到2022年3月只剩0.42。
在平均之前,对比更扎眼。美联储远期曲线本身,三个因子占93.5%。同样九个期限、不取平均的纯噪声远期,只有34.4%。远期曲线也是同一个六参数拟合出来的,市场的身影在平均之前就在。
— 本文基础部分完 —
以上是普通读者的部分,三个数字是什么、稳不稳、有多少是真的。往下是动手的部分,这三个数字在哪里骗人,代码怎么抄。
五、第一个数字不是平行移动
水平因子听着像整体升降,久期对冲听着天经地义。它有个毛病,美联储把短端钉住的时候,它会歪。
道理其实很直白。一个收益率被摁在零附近,日变化几乎为零,算相关的时候它几乎不出声。短端被钉住时,第一因子不再扛起整条曲线,变成主要是长端在动。
这个歪怎么量?看第一因子在1年的载荷除以它的最大载荷。严格平行移动应该是1。全样本0.59。按日历年重拟合,1989年0.86,2013年0.06,中间一路滑下来。
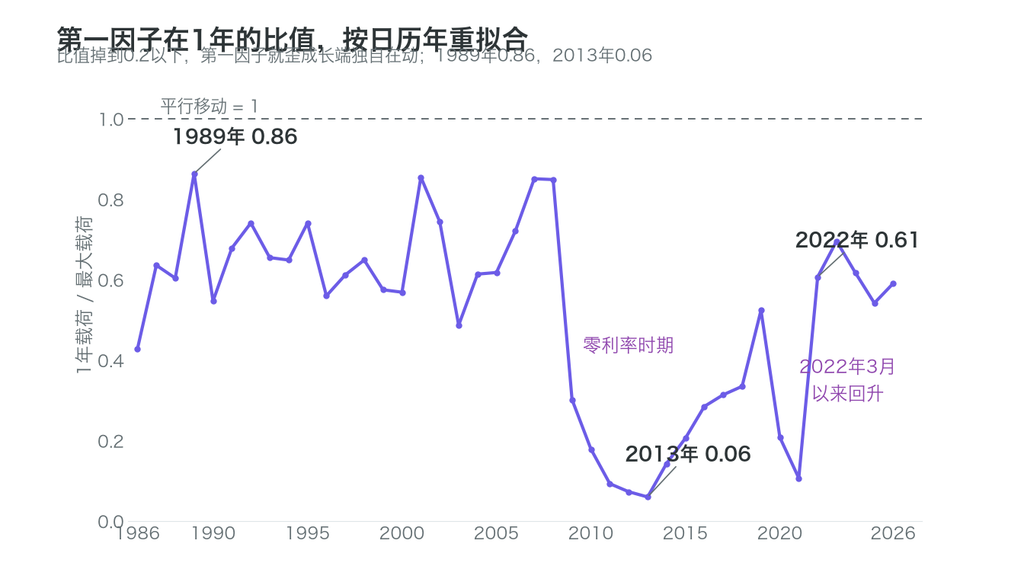
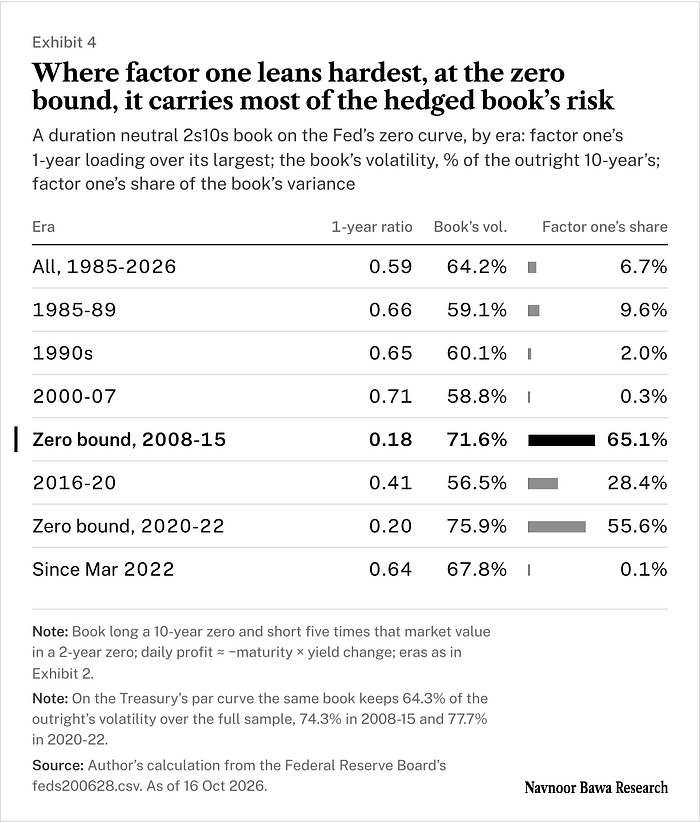
2s10s组合的账要这么算。零利率时期第一因子歪得最厉害,也恰好扛走了组合的大部分风险。久期中性只保证平行移动下不亏,不保证曲线不歪。
六、两种漏法,2013和2023
同一个组合,两种漏法,差别全在前端的状态。
2013年5月22日,时任美联储主席伯南克对国会联合经济委员会说,美联储准备加快或放慢资产购买的速度,可能在接下来几次会议上开始缩减。当天10年零息利率涨9.6个基点,1年跌0.9,长端自己走。整个夏天组合亏9.5%,裸持亏10.9%,87%留在账上。那年第一因子的1年比值0.06,歪到极致。
2023年3月10日,加州监管机构关闭硅谷银行。3月13日,节后第一个交易日,1年零息利率跌59.5个基点,2年跌51.6,10年只跌12.3。债券价格反过来,10年零息涨1.2%,2年零息涨1.0%。做多的长腿每股赚得稍多,但空腿的名义是长腿的五倍,做空的部分涨了就是亏,组合当天亏3.9%。
规律在两头。美联储按住前端,零利率,或者提前打招呼的慢加息,第一因子扛着漏。前端自由移动,斜率扛着漏。2016和2017年美联储缓慢加息且提前沟通,第一因子占比50.6%和54.5%,正好卡在两种状态中间。全样本四十年的平均只有6.7%,平均在这里是最骗人的数字。
七、3个数字还有三个坑
先说对冲工具。一把尺子压不住两个模式。拿单腿2年去对冲10年,波动还剩62.8%,久期中性的还剩64.2%,差不多。剩下的主要是斜率,按主成分对冲的交易台会上第二把尺子。
再说留几个。Crump和Gospodinov在《Econometrica》2022年那篇里给了一个数值例子:拟合得好看就锁定一个极简的因子空间,经济代价可能很大。噪声曲线正好说明这个警告在这里为什么咬人。支撑三个就够的那个拟合优度,大部分是算术白送的。九个期限里,第三因子基本就是30年,曲率载荷0.805。
还有个坑很常见,把PCA跑在收益率水平值上。同一段1985到2026,水平值三因子占比99.9%,第一因子95.2%,好看得很。所有期限一起涨跌,水平值里就全是共同趋势。我脚本里专门留了这组对照,日变化的97.8%和83.9%才是能用的数。
还有个更隐蔽的,特征向量会漂移。方差占比在七个时代之间几乎不动,背后的特征向量在换形状。数据科学家管这个叫协变量偏移,它还发生在特征基底里。对冲依赖的是特征向量,不是占比,载荷必须按时代重新拟合。这个规律也只是个相关,那些年还带着别的政策,说不好哪个是因。
时代边界我第一版按决议日切,零利率第二段的第一因子占比算出51.9%,对不上图表里的55.6%。差两个交易日的事。后来才想明白,时代要把决议日那天包起来,重切之后55.6%对上了。
八、动手区
先说个我自己的坑。第一版脚本我把九个因子的得分全打了出来,2013年那行赫然九个数字,后来才反应过来只要前三个。改成前三个重跑,215.4、94.2、-18.7,一个不差。
核心代码两段。第一段从美联储的公开文件重建三个数字,八行。
import numpy as np, pandas as pd
url = "https://www.federalreserve.gov/data/yield-curve-tables/feds200628.csv"
cols = [f"SVENY{m:02d}" for m in (1, 2, 3, 5, 7, 10, 15, 20, 30)]
curve = pd.read_csv(url, skiprows=9, index_col=0, parse_dates=True, storage_options={"User-Agent": "Mozilla/5.0"})
dy = curve.loc["2022-03-16":, cols].dropna().diff().dropna().to_numpy()
lam, vec = np.linalg.eigh(np.cov(dy, rowvar=False))
lam, vec = lam[::-1], vec[:, ::-1]
print((lam[:3] / lam.sum()).round(3), vec[:, :3].round(3), sep="\n")
第二段是噪声曲线,不用下载任何东西,直接打印0.925。
import numpy as np
rng = np.random.default_rng(20261023)
fwd = rng.normal(0, 0.05, size=(10_000, 360))
zero = np.column_stack([fwd[:, :m * 12].mean(axis=1) for m in (1, 2, 3, 5, 7, 10, 15, 20, 30)])
lam = np.linalg.eigvalsh(np.cov(zero, rowvar=False))[::-1]
print(round(lam[:3].sum() / lam.sum(), 3))
几个口径要注意。收益率取日变化,不取水平值。特征向量的符号每次都会翻,固定成水平短端为正、斜率长端为正再比较。时代边界按美联储零利率决议日切。组合盈亏用期限乘收益率变化近似,不含息票、carry和凸性。
文末有完整脚本,Fed文件和财政部数据一起下,本文每个数字都在里面。
九、有人把证伪条件写在了明处
有人拿这条线下了个赌注,条件写得很细。如果2027年日历年,美联储1年零息利率均值高于3%,那一年久期中性2s10s组合里第一因子占比不超过10%,以2028年1月31日读取的文件为准。1年均值不超过3%,赌约作废。
我按同样口径数了一遍。22个1年均值高于3%的完整年份里,13次第一因子占比压在10%以下。2022年以来的四个年份全部低于这条线,2023年4.4%,2024年2.5%,2025年4.3%,2026年到10月16日8.2%。
这种写法我认。数字、条件、作废条款都摆在明处,到日子自动见分晓。比长期看好有价值得多。
十、把三个数字用到自己的组合上
方法不神秘。把自己组合的美元久期放进九个期限桶,分别点乘三个载荷列再求和。第一个和算的是水平暴露,第二个是斜率,第三个是曲率。2s10s组合久期配平后,第一个和小,第二个扛着交易本身。载荷八行代码就能从美联储文件里重建。
我建议大家晚上就把自己组合的久期桶填进去,level、slope、curvature三个暴露各算一个数。你的组合久期配平之后,slope那一栏是多少?我很好奇。
完整脚本
Fed文件加财政部数据一起下,全样本分解、时代表、噪声曲线、两个窗口的盈亏都在里面,本文每个数字都能在这里面对上。
import numpy as np, pandas as pd, urllib.request, os

os.makedirs("repro_data", exist_ok=True)
UA = {"User-Agent": "Mozilla/5.0"}
MAT9 = [1, 2, 3, 5, 7, 10, 15, 20, 30]
ZCOLS = [f"SVENY{m:02d}" for m in MAT9]

def get(url, path):
    if not os.path.exists(path):
        with urllib.request.urlopen(urllib.request.Request(url, headers=UA), timeout=180) as r, open(path, "wb") as f:
            f.write(r.read())
    return path

curve = pd.read_csv(get("https://www.federalreserve.gov/data/yield-curve-tables/feds200628.csv", "repro_data/feds200628.csv"), skiprows=9, index_col=0, parse_dates=True)
z = curve.loc["1985-11-25":, ZCOLS].dropna()
dy = z.diff().dropna().to_numpy()

lam, vec = np.linalg.eigh(np.cov(dy, rowvar=False))
lam, vec = lam[::-1], vec[:, ::-1]
print("三因子占比", (lam[:3] / lam.sum()).round(4))
print("载荷(前三个因子)\n", vec[:, :3].round(3))

rng = np.random.default_rng(20261023)
fwd = rng.normal(0, 0.05, size=(10_000, 360))
zero = np.column_stack([fwd[:, :m * 12].mean(axis=1) for m in MAT9])
ln = np.linalg.eigvalsh(np.cov(zero, rowvar=False))[::-1]
print("噪声曲线三因子占比", round(float(ln[:3].sum() / ln.sum()), 4))
#收益率曲线 #PCA #主成分分析 #高盛 #久期对冲 #美联储 #国债 #量化交易 #2s10s #taper tantrum
觉得有用的话,把这篇转给同样在跑回测的朋友。
Be First to Comment